Yapay zekâ kodu hızlandırdı, peki zaman nereye gidiyor?
27 Ekim'de GPT-6.1 Terra çıktı, Microsoft kodlama ajanlarını ölçen Scope'u açtı, Atlassian'ın raporu ise kazanılan zamanın eridiğini gösterdi. Ne değişiyor?
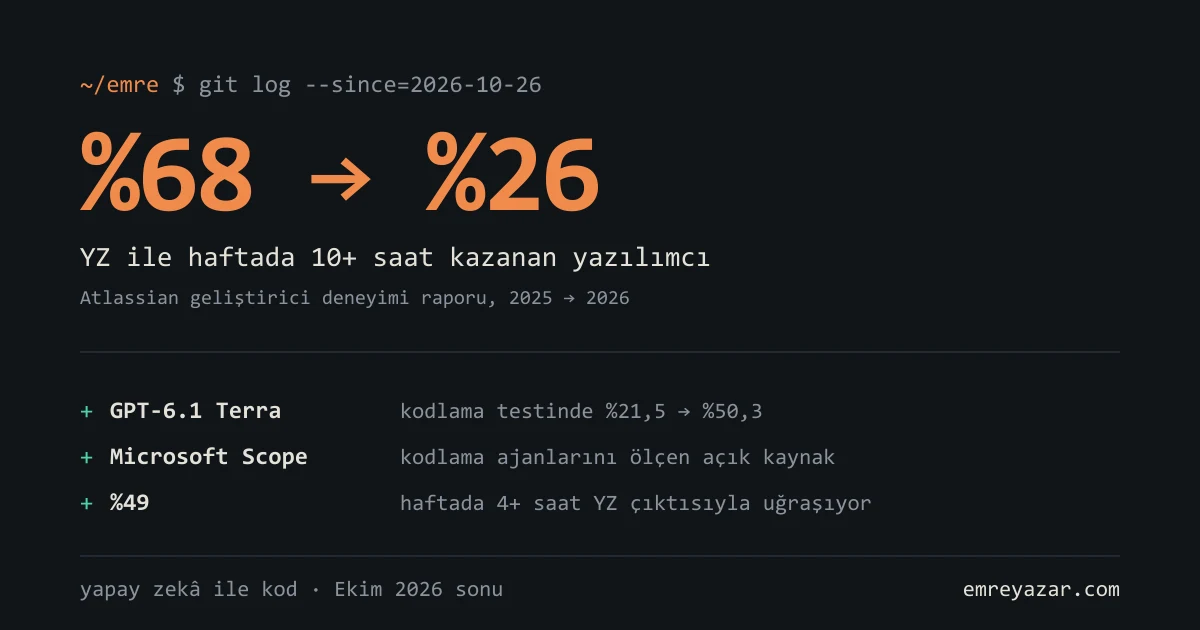
Ekim’in son haftası yapay zekâ ile yazılım geliştirme açısından yoğun geçti. 27 Ekim’de OpenAI, kod yazmada bir öncekinin iki katından fazla başarılı ve yarı fiyatına çalışan GPT-6.1 Terra’yı çıkardı. Microsoft’un yapay zekâ kodlama ajanlarını ölçmek için açık kaynak yaptığı Scope gündeme oturdu. Aynı günlerde Atlassian’ın yazılımcılarla yaptığı yıllık araştırmanın sonuçları konuşulmaya başladı.
İlk iki haber “daha hızlı, daha ucuz” diyor. Üçüncüsü ise başka bir şey söylüyor: Yapay zekâ ile haftada 10 saatten fazla zaman kazandığını söyleyen yazılımcıların oranı bir yılda yüzde 68’den yüzde 26’ya düştü.
Bu yazıda üç haberi yan yana koydum. Çünkü bana kalırsa asıl hikâye ikisinin arasındaki boşlukta: Kod yazmak hızlandı, ama zaman başka bir yere akıyor.
Kısaca
- GPT-6.1 Terra (27 Ekim): OpenAI’ın bilgisayarda iş yapan, kod yazan yeni modeli. Kodlama testinde başarısı %21,5’ten %50,3’e çıktı, fiyatı yarıya indi.
- Microsoft Scope: Yapay zekâ kodlama ajanlarının bir yazılımla ne kadar iyi çalıştığını ölçen, ücretsiz ve açık kaynak bir araç.
- Atlassian 2026 raporu: Yazılımcıların %95’i yapay zekâ kullanıyor. Ama büyük zaman kazandığını söyleyenler azaldı ve yaklaşık yarısı haftada 4 saatten fazlasını yapay zekânın işini yönetmeye harcıyor.
- Ortak mesaj: Kodu yazmak kolaylaştı. Zor olan artık yazılanı kontrol etmek, doğrulamak ve sorumluluğunu almak.
GPT-6.1 Terra: daha hızlı, daha ucuz, daha yetenekli
OpenAI’ın duyurusuna göre Terra, bilgisayarda yazılım kullanabilen ve iş yapabilen bir model. OpenAI’ın verdiği örnek, gündelik hayattan: Gelen faturaları okuyup bilgileri muhasebe programına girmek.
Yazılımcıları ilgilendiren kısım kod tarafı. Help Net Security’nin aktardığına göre, komut satırında gerçek görevler veren Terminal-Bench 4.0 testinde Terra, en yüksek düşünme ayarında görevlerin %50,3’ünü çözüyor. Önceki sürüm GPT-5.6 Terra için yayınlanan rakam %21,5’ti. Fiyatı da öncekinin yarısı.
İki not düşmek lazım. Birincisi, bu rakamların çoğu OpenAI’ın kendi testlerinden geliyor; bağımsız değerlendirmeler henüz az. İkincisi, en iyi ayarında bile görevlerin yaklaşık yarısını çözemiyor. OpenAI de en karmaşık kodlama işleri için başka modellerini öneriyor.
Bir ayrıntı daha var ve bence en önemlisi bu. OpenAI, Terra’nın kendi risk ölçeğinde siber güvenlikte “kritik” seviyeye ulaştığını söylüyor. Bu seviye, yapay zekânın gerçek sistemlerde açık bulup bu açıktan çalışan bir saldırı üretebilecek kadar yetenekli olması demek. OpenAI bu yüzden modeli ek güvenlik önlemleriyle yayınladığını belirtiyor. Bir önceki PHP2Shell yazımda anlattığım olay bu ölçeğin pratikteki karşılığıydı: Yıllarca kimsenin görmediği bir açığı yapay zekâ ile çalışan ekipler buldu, saldırganlar da birkaç saat içinde peşine düştü.
Microsoft Scope: yapay zekâ yazılımınızı nasıl kullanıyor?
İkinci haber daha az konuşuldu, ama yazılım ürünü yapan herkes için ilginç. Microsoft’un tanıttığı Scope, yapay zekâ kodlama ajanlarına bir yazılımla ilgili gerçekçi görevler veriyor, ne yaptıklarını kaydediyor ve sonucu puanlıyor.
Yazılımcı olmayanlar için şöyle anlatayım: Eskiden bir yazılım kütüphanesini ya da servisini insanlar kullanırdı. Belgeleri insanlar okur, örnek kodu insanlar kopyalardı. Artık bu işin bir kısmını yapay zekâ ajanları yapıyor. Bir servis insanlar için gayet anlaşılır olabilir, ama ajan yanlış yöntemi seçip takılıp kalabilir. Scope, bu farkı ölçmek için yapılmış.
Microsoft’un kendi örneği somut. Azure Cosmos DB ekibi Scope ile yaptığı denemelerde, ajanların takıldığı yerlerden yola çıkarak 20 araç sorunu ve 27 belge sorunu düzeltti. Hedeflenen tek bir güncellemeden sonra, ajanların önerilen yöntemi kullanma oranı test edilen senaryolarda %47’den %100’e çıktı.
Bence buradaki fikir, aracın kendisinden daha önemli: Artık ürünümüzü yalnız insanlar için değil, onu kullanacak yapay zekâ için de tasarlıyoruz. Belgeleri net olan, örnekleri doğru olan ürün, ajanın da doğru kullandığı ürün oluyor.
Atlassian raporu: kod hızlandı, zaman başka yere gitti
Üçüncü haber, ilk ikisinin hevesini biraz dengeliyor. Atlassian’ın 2026 Geliştirici Deneyimi raporu, 1.155 yazılımcı ve 405 yönetici ile yapılmış. InfoQ’nun özetine göre öne çıkan rakamlar şunlar:
- Yazılımcıların %95’i, şirketlerinde yapay zekânın aktif olarak kullanıldığını söylüyor.
- %87’si yapay zekânın daha hızlı iş çıkarmalarına yardım ettiğini düşünüyor.
- Ama haftada 10 saatten fazla kazandığını söyleyenlerin oranı bir yılda %68’den %26’ya düştü.
- Yazılımcıların %49’u haftada 4 saatten fazlasını yapay zekâ araçlarını yönetmeye harcıyor.
- %65’i, asıl isteği ıskalayan yapay zekâ çıktısını düzeltmekle zaman kaybediyor.
- Yapay zekâ öncesine göre işlerinin belirgin şekilde kolaylaştığını söyleyenler yalnız %28.
Atlassian’ın yapay zekâdan sorumlu teknoloji yöneticisinin raporda söylediği cümle durumu iyi özetliyor: Darboğaz, yapay zekânın işini yönetmeye kaydı.
Raporu okurken iki şeyi akılda tutmak gerekiyor. Birincisi, bunlar ölçüm değil, kişilerin kendi beyanı. İkincisi, rapor yazılımcılara araç satan bir şirketten geliyor. Yine de yönü tutarlı ve tanıdık.
Bir rakam daha dikkatimi çekti: Yazılımcıların zamanının en çok nereye gittiği sorulduğunda ilk sıralarda bilgi aramak, toplantılar, bir işten ötekine geçmek ve eski koddan kalan teknik borç çıkıyor. Kod yazmak bu listede hiç yer almamış. Yani yapay zekâ, zaten darboğaz olmayan kısmı hızlandırıyor.
Bu üç haber birlikte ne söylüyor?
Kod yazmak ucuzladı. Terra’nın fiyatı yarıya indi, başarısı ikiye katlandı. Bir sonraki model muhtemelen daha da ucuz olacak.
Ucuzlamayan şey, yazılan kodun doğru olduğundan emin olmak. Birinin o kodu okuması, isteneni yapıp yapmadığına bakması, güvenli olduğunu kontrol etmesi ve yayına çıkınca sorumluluğunu alması gerekiyor. Atlassian’ın raporundaki “haftada 4 saat” tam olarak bu iş. Microsoft’un Scope’u da aslında aynı soruya cevap arıyor: Yapay zekânın yaptığı işin iyi olup olmadığını nasıl ölçeceğiz?
İşin güvenlik tarafı da aynı yere çıkıyor. Terra gibi modeller açık bulmakta ve bu açıkları kullanmakta “kritik” seviyeye ulaştıysa, kontrol edilmeden yayına çıkan her kod satırı daha büyük bir risk taşıyor. Hızlı yazılmış ama incelenmemiş kod, bulunması da hızlı bir açık olabilir.
Bir ürün sahibi olarak bana düşündürdükleri
Masada, Ne Zaman ve Kısacık’ı her gün gerçek işletmeler kullanıyor. Masada’yı kullanan bir kafe için bir hatanın bedeli, yoğun bir öğle saatinde menünün açılmaması. Bu yüzden bence asıl soru “kodu ne kadar hızlı yazarım” değil, “yayına çıkan şeyin doğru çalıştığından nasıl emin olurum”.
Bu haftanın haberleri bana bu sorunun daha da önemli hâle geldiğini düşündürdü. Yapay zekâ kodu hızlandırıyorsa, kazanılan zamanın bir kısmını kontrol etmeye, test yazmaya ve güvenlik incelemesine ayırmak bence en akıllıca yatırım. Hızın kendisi bir kazanç değil; doğru çalışan bir ürüne dönüştüğü kadar kazanç.
İş sahipleri için de bir not: Bir yazılımcıya ya da ajansa iş verirken “yapay zekâ ile daha hızlı ve ucuz yaparız” cümlesini duyarsanız, bir soru daha sorun: “Peki yazılanı kim, nasıl kontrol ediyor?” Bu sorunun net bir cevabı varsa, hız gerçekten işinize yarar.
Sık sorulan sorular
GPT-6.1 Terra nedir?
OpenAI’ın 27 Ekim 2026’da çıkardığı, bilgisayarda yazılım kullanabilen ve kod yazabilen yapay zekâ modeli. OpenAI’a göre kodlama testinde önceki sürümün iki katından fazla başarılı ve fiyatı yarısı kadar.
Microsoft Scope ne işe yarıyor?
Yapay zekâ kodlama ajanlarının bir yazılımı, belgesini ya da servisini ne kadar doğru kullandığını ölçen açık kaynak bir araç. Özellikle yazılım kütüphanesi, servis ya da araç geliştiren ekipler için yapılmış.
Yapay zekâ yazılımcıların zamanını gerçekten kazandırıyor mu?
Atlassian’ın 2026 raporuna göre yazılımcıların çoğu daha hızlı çalıştığını hissediyor. Ama büyük zaman kazandığını söyleyenlerin oranı %68’den %26’ya düştü; yaklaşık yarısı haftada 4 saatten fazlasını yapay zekânın işini yönetmeye harcıyor.
Yapay zekâ ile yazılan kod güvenli mi?
Kendiliğinden ne güvenli ne güvensiz. Önemli olan, kodu kimin yazdığından bağımsız olarak, yayına çıkmadan önce bir insanın incelemesi ve test edilmesi.
Kaynaklar
- OpenAI: Introducing GPT-6.1 Terra
- Help Net Security: GPT-6.1 Terra meets OpenAI’s Critical cyber threshold
- Microsoft Open Source: Introducing Scope
- Atlassian: State of Developer Experience Report 2026
- InfoQ: Developers reporting double-digit weekly time savings from AI fell from 68% to 26%
- SD Times: Developers report mixed feelings as AI adoption hits record highs